Safety, Alignment & Ethics

68 Items

Safety, alignment, ethics. Proofs of safe AGI. Epistemology of provably safe AGI. Provably Compliant Systems.

All Items

  • Pitfalls of Evidence-Based AI Policy

    Stephen Casper, David Krueger, Dylan Hadfield-Menell
    DOI: https://doi.org/10.70777/si.v2i2.14611
  • Strategic Patience: Long-Horizon AI Dominance and the Erosion of Human Vigilance

    Roman Yampolskiy
    DOI: https://doi.org/10.70777/si.v2i2.14435
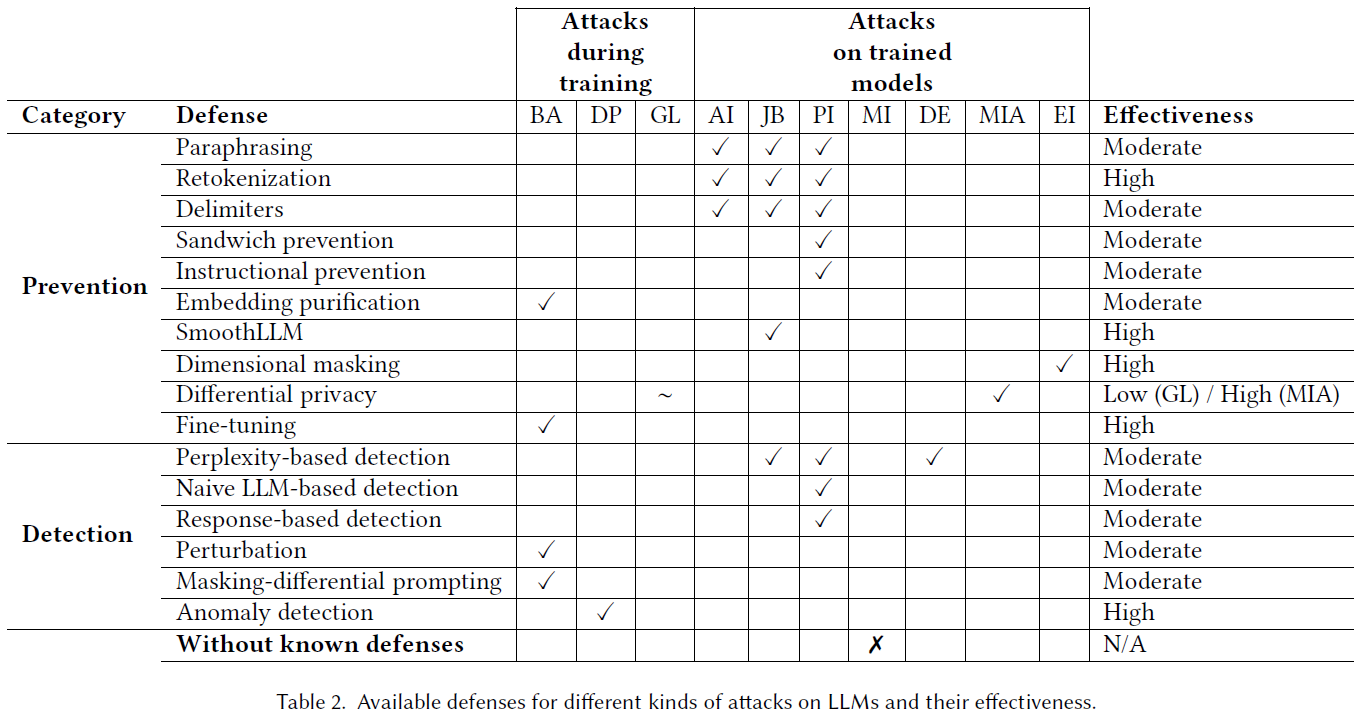
  • LLM Security: Vulnerabilities, Attacks, Defenses, and Countermeasures

    Franciso Aguilera-Martinez, Fernando Berzal
    DOI: https://doi.org/10.70777/si.v2i2.14441
  • A Framework for the Private Governance of Frontier Artificial Intelligence

    Dean Ball
    DOI: https://doi.org/10.70777/si.v2i2.14519
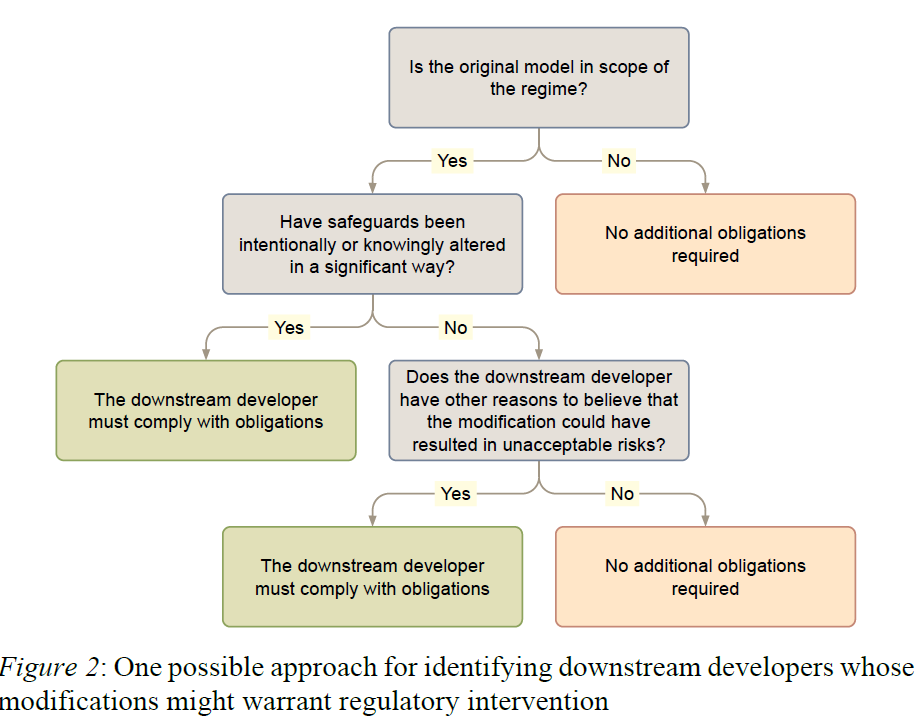
  • Review: On Regulating Downstream AI Developers Sophie Williams, Jonas Schuett, Markus Anderljung

    Kris Carlson
    DOI: https://doi.org/10.70777/si.v2i2.14587
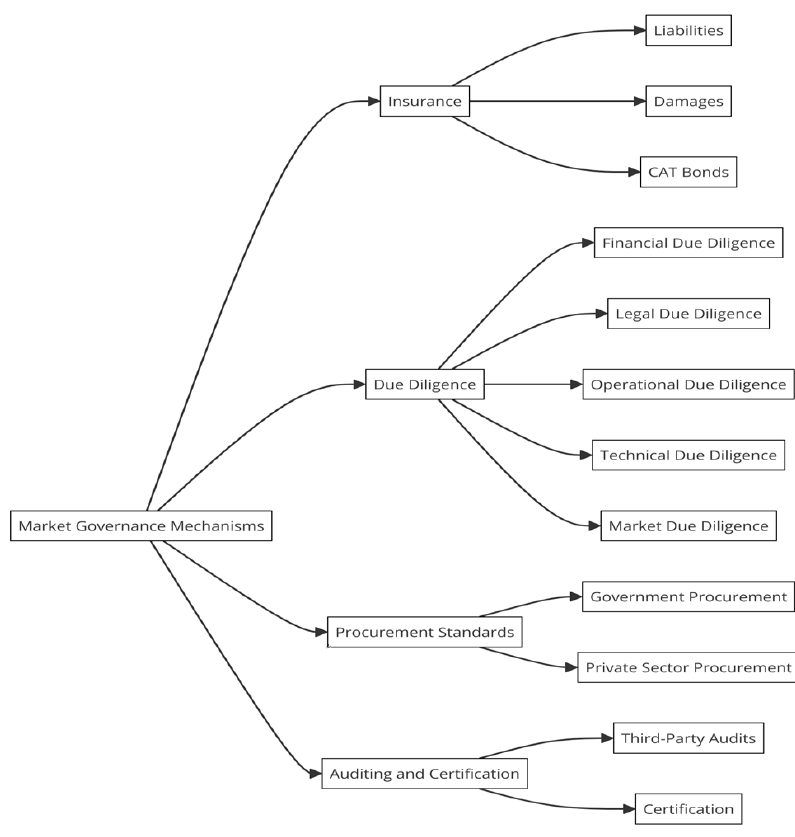
  • Review: AI Governance through Markets Philip Moreira Tomei, Rupal Jain, Matija Franklin

    Kris Carlson
    DOI: https://doi.org/10.70777/si.v2i2.14601
  • Review: Strategic Patience: Long-Horizon AI Dominance and the Erosion of Human Vigilance Roman Yampolskiy

    Kris Carlson
    DOI: https://doi.org/10.70777/si.v2i2.14603
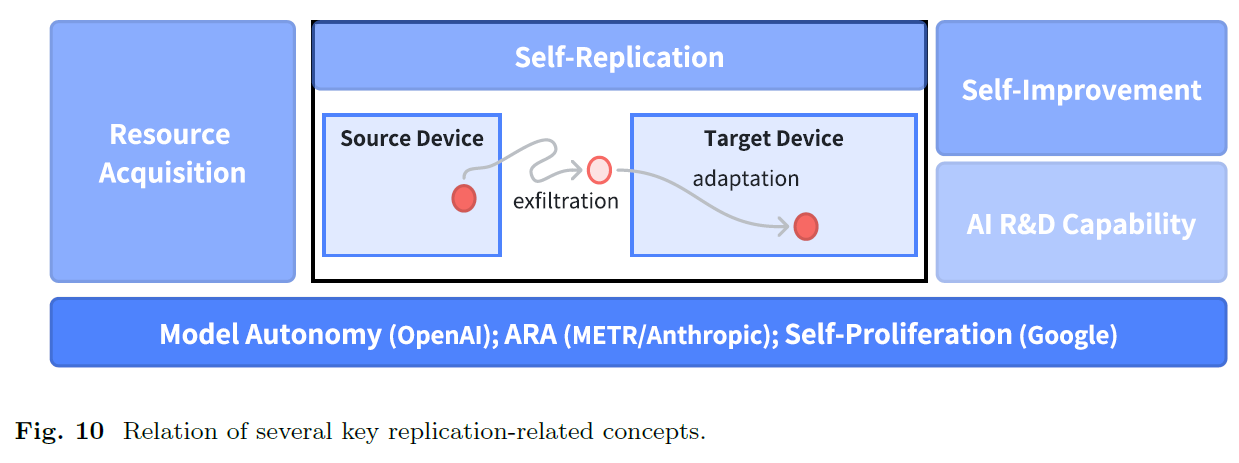
  • Review: Large language Model-Powered AI Systems Achieve Self-Replication with No Human Intervention Xudong Pan (潘旭东), Jiarun Dai† (戴嘉润), Yihe Fan (范一禾), Minyuan Luo (罗铭源), Changyi Li (李长艺), Min Yang∗ (杨珉)

    Kris Carlson
    DOI: https://doi.org/10.70777/si.v2i2.14607
  • Simulating Influence Dynamics with LLM Agents

    Mehwish Nasim, Syed Muslim Gilani, Amin Qasmi, Usman Naseem
    DOI: https://doi.org/10.70777/si.v2i1.13971
  • The Road to Artificial SuperIntelligence: A Comprehensive Survey of Superalignment

    HyunJin Kim, Xiaoyuan Yi, JinYeong Bak, Jing Yao, Jianxun Lian, Muhua Huang, Shitong Duan, Xing Xie
    DOI: https://doi.org/10.70777/si.v2i1.13963
  • Multiple unnatural attributes of AI undermine common anthropomorphically biased takeover speculations Eight Fundamental Differences between Biologically Evolved Humans and Digital AI

    Preston Estep
    DOI: https://doi.org/10.70777/si.v2i1.13801
  • Can a Bayesian Oracle Prevent Harm from an Agent?

    Yoshua Bengio, Matt McDermott, Michael K. Cohen, Nikolay Malkin, Damiano Fornasiere, Pietro Greiner, Younesse Kaddar
    DOI: https://doi.org/10.70777/si.v2i1.13799
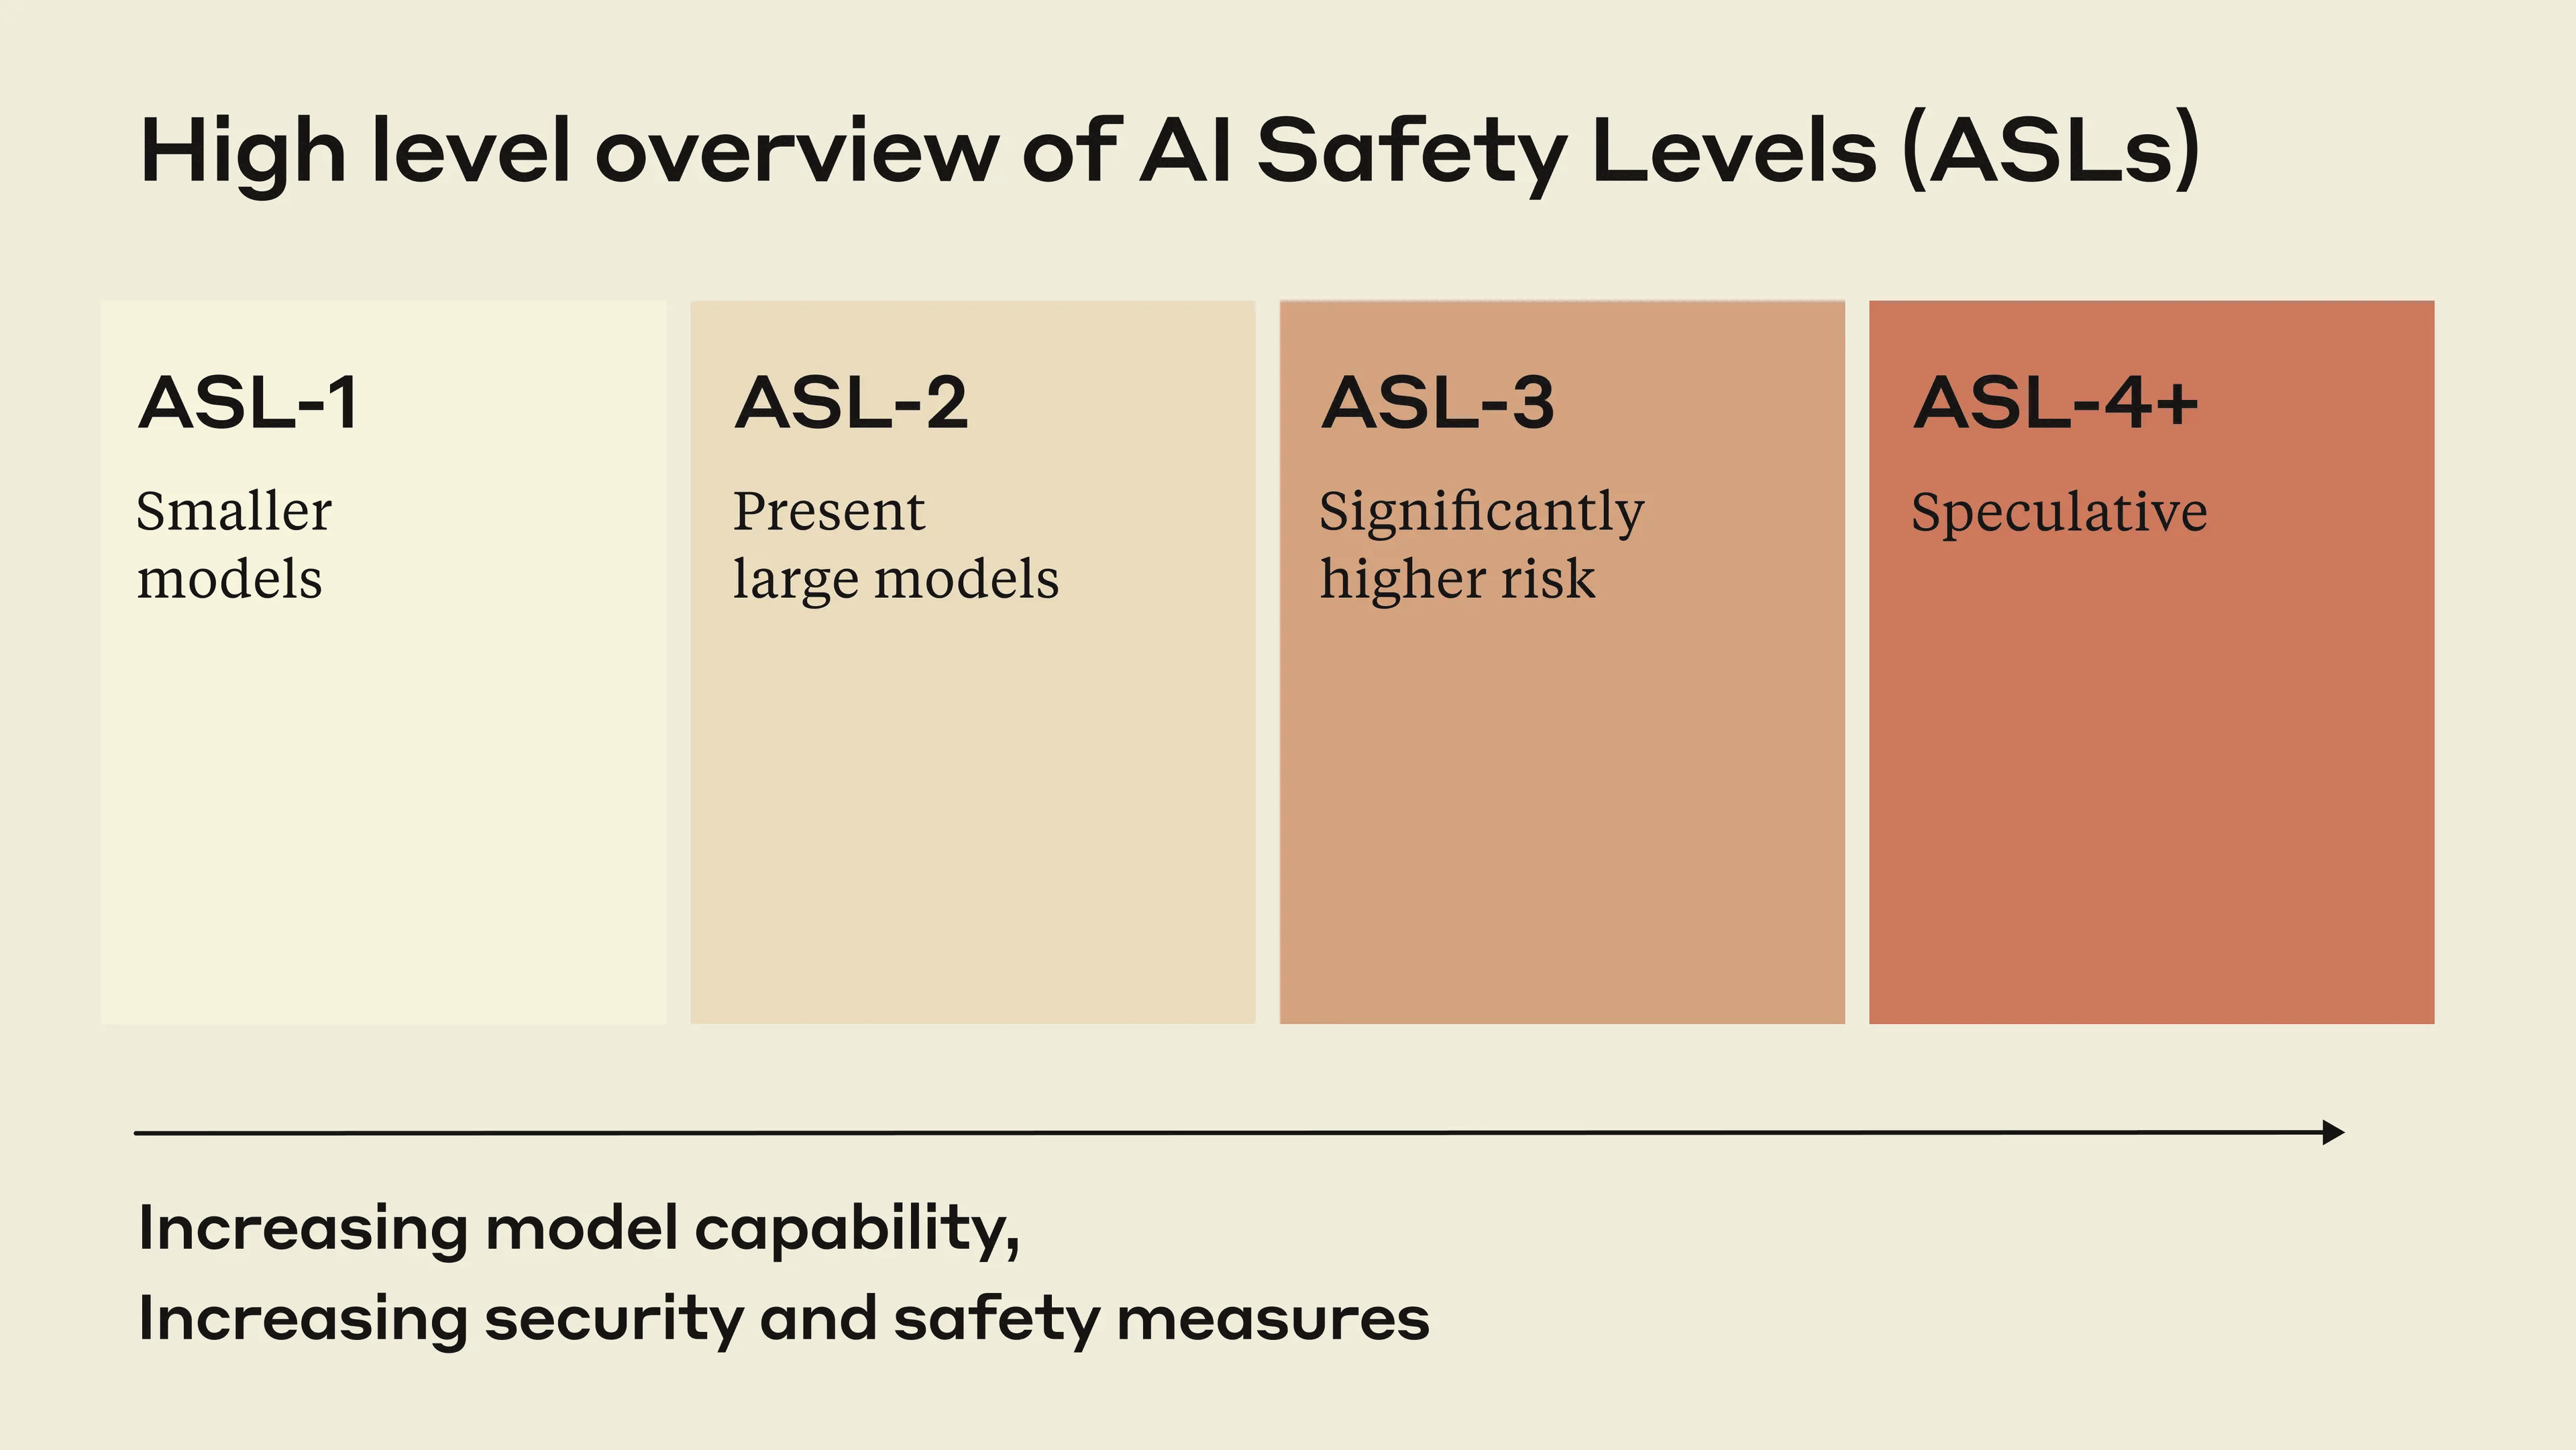
  • Anthropic: Responsible Scaling Policy

    Evan Hubinger
    DOI: https://doi.org/10.70777/si.v2i1.13657
  • Acceptable Use Policies for Foundation Models

    Kevin Klyman
    20
    DOI: https://doi.org/10.70777/si.v1i1.10917
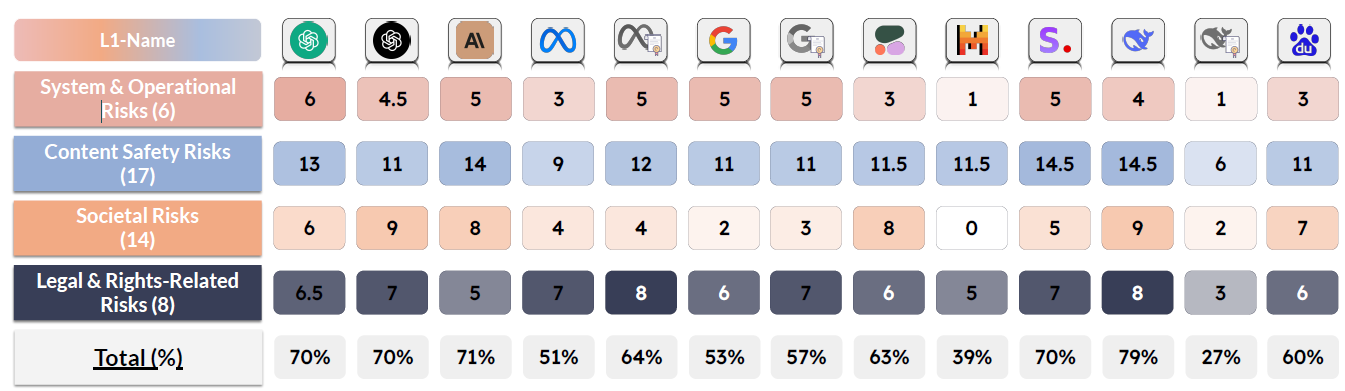
  • AI Risk Categorization Decoded (AIR 2024) From Government Regulations to Corporate Policies

    Yi Zeng, Kevin Klyman, Andy Zhou, Yu Yang, Minzhou Pan, Ruoxi Jia, Dawn Song, Percy Liang, Bo Li
    DOI: https://doi.org/10.70777/si.v1i1.10603
  • Against Purposeful Artificial Intelligence Failures

    Roman Yampolskiy
    DOI: https://doi.org/10.70777/si.v1i1.9943
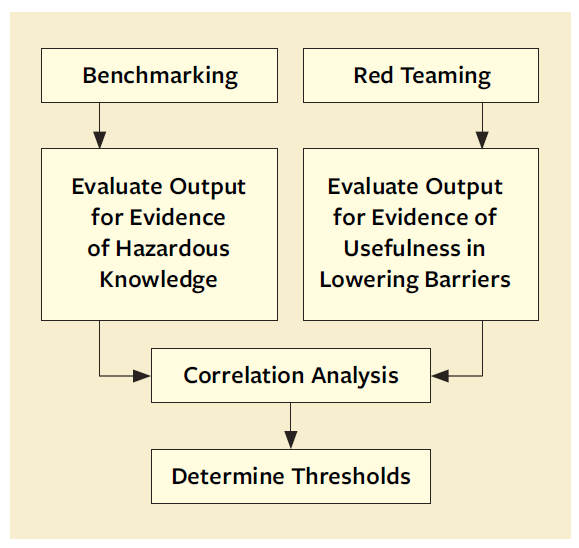
  • Benchmark Early and Red Team Often A Framework for Assessing and Managing Dual-Use Hazards of Ai Foundation Models

    Anthony Barrett, Krystal Jackson, Evan R. Murphy, Nada Madkour, Jessica Newman
    DOI: https://doi.org/10.70777/si.v1i1.10601
  • Unhobbling Is All You Need? On Aschenbrenner’s Situational Awareness

    Ronan McGovern
    DOI: https://doi.org/10.70777/si.v1i1.9945
51-75 of 68